Моделирование угроз веб-приложения под нагрузкой: что ломается первым
Под нагрузкой веб-приложение может отказать не там, где уязвимее всего код: раньше заканчиваются соединения с базой, переполняется очередь или начинает отвечать с ошибками внешний сервис. Разбираем, как включить эти сценарии в модель угроз и что измерять.
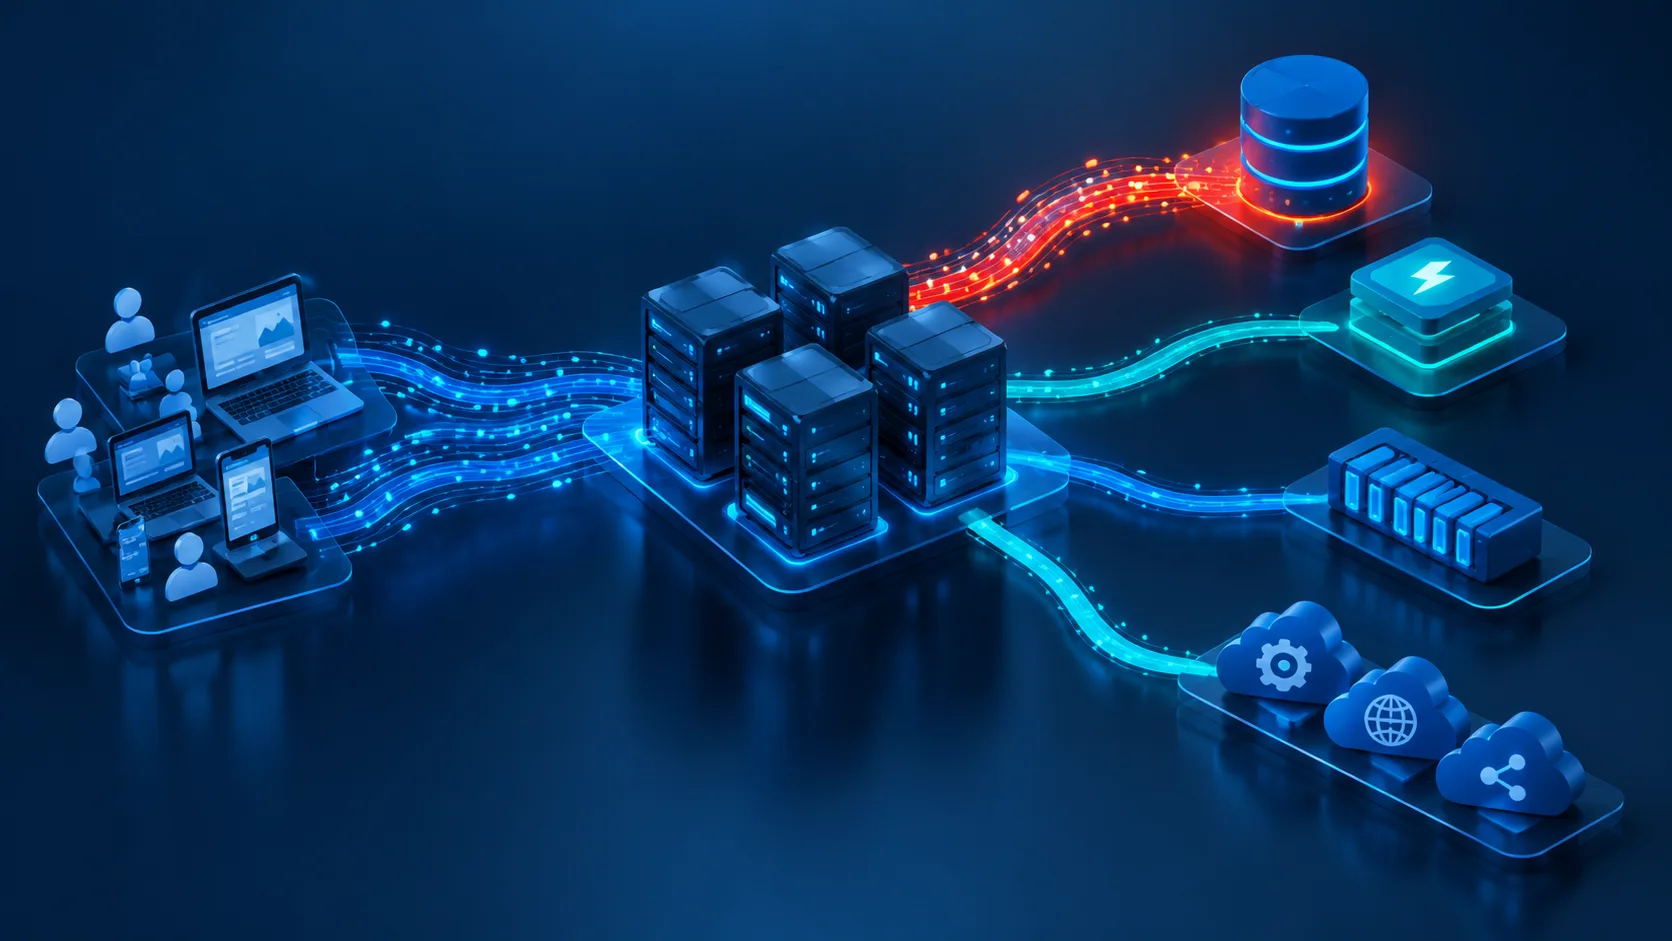
При всплеске запросов первым может отказать не сам веб-сервер, а база данных, очередь задач или внешний сервис, от которого зависит каждый запрос. Модель угроз, построенная только вокруг кражи данных и обхода авторизации, пропустит отказ в обслуживании: легитимный пик нагрузки, боты или дорогой запрос способны сделать приложение недоступным для всех. Ниже — разбор для работающего веб-приложения, без привязки к конкретному фреймворку и без выдуманных замеров.
Почему нагрузка меняет модель угроз
Обычная модель угроз отвечает на вопросы: кто атакует, что защищаем и каким способом на систему воздействуют. Для сценариев под нагрузкой добавляется ещё один: какой общий ресурс исчерпается первым и что перестанет работать вслед за ним?
Пользовательский запрос расходует сразу несколько ресурсов: время вычислений, память, соединение с базой, слот в пуле, место в очереди, лимит внешнего API. Поэтому низкая стоимость запроса для клиента не означает низкую стоимость для сервера. Поиск по широкому диапазону, отчёт с агрегацией или проверка пароля могут оказаться существенно дороже простого чтения страницы.
Граница разбора: здесь речь о доступности и деградации приложения под нагрузкой. Утечки данных и обход контроля доступа важно включить в модель, но подробно разбирать их — отдельная задача.
От запроса до отказа: цепочка обычно длиннее, чем кажется
Нарисуйте путь одного критичного запроса: клиент, балансировщик, приложение, кэш, база, очередь, воркер и внешние зависимости. Для каждого звена задайте три вопроса: какой у него конечный ресурс, сколько запросов одновременно он принимает и что происходит, когда лимит достигнут.
Например, медленный запрос может долго занимать соединение с базой. Пул соединений заполняется, новые обработчики ждут свободный слот, растёт время ответа. Затем запросы накапливаются на уровне приложения или балансировщика. Пользователь видит тайм-аут, хотя исходная причина — не число входящих соединений, а слишком долгая работа нескольких запросов.
Такой сценарий отличается от простого «сервера не хватает». Важны и стоимость отдельной операции, и её умножение на параллельность. Если запрос запускает несколько обращений к зависимостям или создаёт задачу на каждый повтор, нагрузка может расти быстрее, чем число клиентов.
Что проверять в первую очередь
| Узел | Что может исчерпаться | Что смотреть | Сценарий проверки |
|---|---|---|---|
| Приложение | Рабочие процессы, память, CPU | Очередь запросов, задержки, перезапуски, память | Растёт ли ожидание при медленных обработчиках |
| База данных | Соединения, CPU, блокировки | Занятые соединения, время запросов, ожидания блокировок | Что происходит при параллельном запуске дорогой операции |
| Очередь и воркеры | Место в очереди, пропускная способность | Длина и возраст очереди, скорость обработки, ошибки | Успевают ли воркеры обработать поступающие задачи |
| Внешний сервис | Лимит запросов, соединения, время ожидания | Тайм-ауты, ошибки, повторные вызовы | Не блокирует ли медленный ответ обработчик приложения |
| Кэш | Память, пропускная способность, доступность | Попадания и промахи, задержки, ошибки подключения | Не превращается ли промах в одновременный запрос к базе |
Таблица — не универсальный список метрик: названия и доступность показателей зависят от стека. Важно собирать их с временными отметками, чтобы связать рост задержки на пользовательском запросе с ожиданием базы, очереди или внешнего ответа.
Как превратить наблюдения в модель угроз
- Выберите критичный пользовательский путь. Например, оформление заказа или вход в личный кабинет. Зафиксируйте, какие компоненты участвуют и какие из них общие для других функций. Проверка: на схеме нет шага, который приложение выполняет «где-то ещё» без указания зависимости.
- Опишите источник нагрузки. Учитывайте не только злоумышленника, но и распродажу, массовую рассылку, повторные запросы клиента и автоматические ретраи сервисов. Проверка: для каждого сценария понятно, кто или что создаёт нагрузку и почему запросы могут повторяться.
- Найдите ограниченные ресурсы. Для каждого узла укажите предел, способ его измерить и поведение при исчерпании. Если предела пока нет в документации или мониторинге, отметьте это как пробел. Проверка: команда может назвать сигнал, по которому узнает о приближении к отказу, а не только о том, что он уже произошёл.
- Проследите каскад. Запишите, как отказ одного звена влияет на соседние: тайм-аут внешнего сервиса удерживает обработчики, ретраи увеличивают поток, соединения с базой перестают освобождаться. Проверка: для сценария виден путь от первичной перегрузки до ошибки, которую заметит пользователь.
- Проверьте гипотезу нагрузочным тестом. Наращивайте нагрузку постепенно и отдельно тестируйте дорогие операции, тайм-ауты и недоступность зависимости. Фиксируйте конфигурацию, объём данных, параллельность и длительность теста. Проверка: графики показывают не только среднее время ответа, но и хвост задержек, ошибки и состояние зависимостей.
Нагрузочный тест должен проходить в среде, где его последствия контролируемы. Без согласования не направляйте тестовый трафик на чужие системы или общие производственные зависимости.
Граничные случаи: где модель часто врёт
«Среднее время ответа нормальное»
Среднее скрывает запросы, которые зависают дольше остальных. Для доступности важны хвосты распределения задержек, доля ошибок и время ожидания отдельных зависимостей. Сравнивайте показатели для конкретного маршрута и периода нагрузки, а не только общую цифру по сайту.
«Мы ограничили число запросов»
Лимит на входе полезен, но не доказывает, что защищён дорогой внутренний путь. Один запрос может запускать несколько обращений к базе или создавать фоновые задачи. Проверьте, где именно применяется ограничение, как оно учитывает клиента и что происходит с задачей после постановки в очередь.
«Зависимость упала, но приложение переживёт»
Если обработчик синхронно ждёт внешний сервис, его медленный ответ может занять рабочие процессы и соединения. Если клиент повторяет запрос без ограничений, краткий сбой превращается в дополнительный поток. Проверьте тайм-ауты, поведение повторов и сценарий частичной недоступности. Не считайте кэш гарантированным спасением: при его отказе или массовом истечении записей нагрузка может перейти на базу.
Важно: реальные пороги нельзя вывести из названия технологии. Их измеряют на вашей конфигурации и данных: результат зависит от железа, пула соединений, запросов, кэша и профиля трафика.
Модель угроз под нагрузкой начинается не с вопроса «сколько запросов выдержит сервер», а с вопроса «какой конечный ресурс исчерпается, и что система сделает в следующие секунды».
Термин: каскадный отказ
Каскадный отказ — ситуация, когда проблема в одном компоненте перегружает связанные компоненты и расширяет сбой. Например, медленный внешний сервис удерживает обработчики приложения; новые запросы накапливаются, а повторные попытки увеличивают нагрузку на зависимость.
Что делать дальше
Возьмите один путь, который приносит деньги или открывает доступ к важным данным, и проведите его по схеме до последней зависимости. Для каждого узла назначьте владельца метрики и проверку сценария отказа. После теста фиксируйте не только точку, где появились ошибки, но и первое отклонение: рост очереди, ожидания соединения или задержки зависимости. Именно этот сигнал обычно даёт время вмешаться до того, как проблему заметят пользователи.
Подход опирается на NIST SP 800-30 Rev. 1 и рекомендации OWASP по моделированию угроз; конкретные метрики и лимиты нужно сверять с документацией версий компонентов вашего стека.
Таможенный брокер (ВЭД): Коды ТН ВЭД, маркировка «Честный ЗНАК», сертификация.
Спросить за 20 ₽Источники: NIST SP 800-30 Rev. 1: Guide for Conducting Risk Assessments, OWASP Threat Modeling Cheat Sheet
Частые вопросы
Можно ли определить, что сломается первым, только по схеме архитектуры?
Нужно ли учитывать легитимный всплеск трафика как угрозу?
Какие цифры нагрузки использовать в тесте?
Достаточно ли поставить rate limit на балансировщике?
Что проверять в проде после нагрузочного теста?
Нужно ли менять модель после изменения версии фреймворка?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.