Мониторинг конвейеров данных: от сбоя до алерта
В Airflow метрика о задаче проходит через несколько слоёв, прежде чем попасть на дашборд. Разбираем этот путь, показываем, почему зелёный статус DAG не всегда означает свежесть данных и какие сигналы стоит проверять в проде.
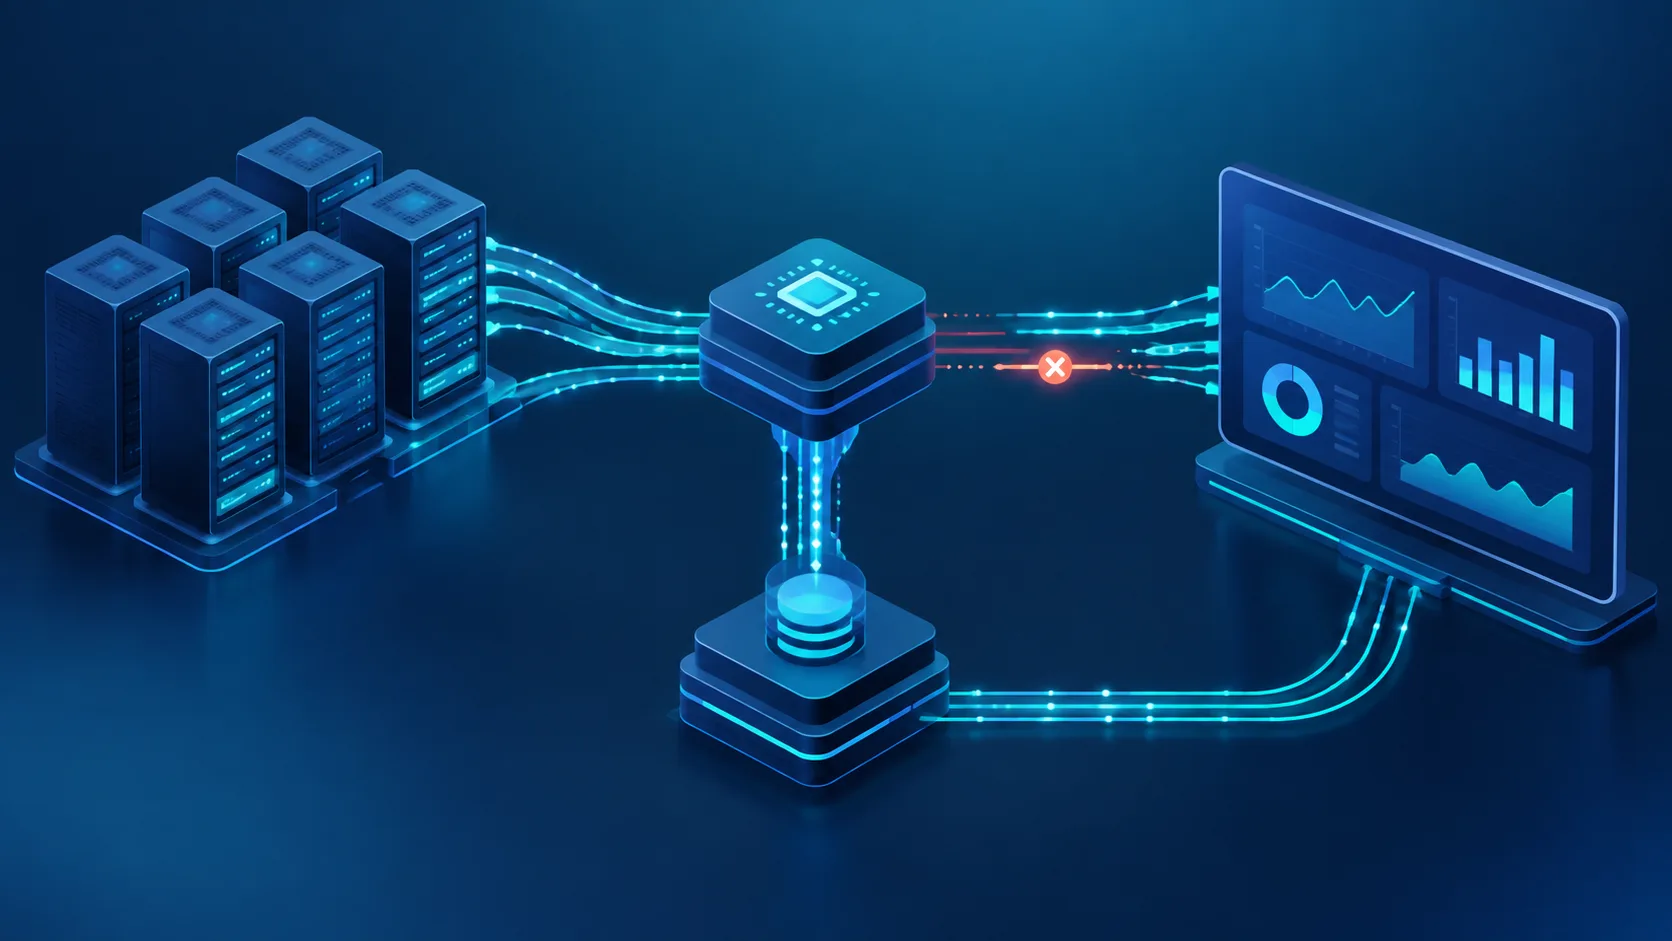
В Apache Airflow 2.10.x задача может завершиться ошибкой, а алерт об этом всё равно придёт с задержкой или не придёт вовсе: метрика проходит от компонента Airflow через StatsD до сборщика, а состояние данных живёт отдельно от состояния задачи. Разберём, как устроена эта цепочка, где в ней теряются сигналы и что проверять, если конвейер зелёный, а отчёт опоздал.
Что именно мониторит Airflow
Airflow управляет выполнением задач, но сам по себе не доказывает, что результат вычисления верен. Он знает, когда планировщик увидел запуск, какую задачу передал исполнителю и в каком состоянии та завершилась. Он не обязательно знает, что загрузка получила все нужные записи или что витрина содержит данные за ожидаемый день.
В типичном запуске Airflow 2.10.x компоненты разделены: планировщик обрабатывает расписание и состояние DAG, исполнитель организует запуск, а задача выполняется в рабочем процессе. Состояния задач сохраняются в метабазе Airflow. Журналы выполнения — отдельный канал: они помогают разобраться в конкретном запуске, но не заменяют метрики и не гарантируют, что сборщик их вовремя получил.
Поэтому мониторинг складывается из разных сигналов:
- Состояние выполнения: задача запустилась, завершилась, упала или повторяется.
- Задержки: сколько задача ждала запуска и сколько выполнялась.
- Здоровье компонентов: жив ли планировщик, не отстаёт ли обработка DAG, доступна ли метабаза.
- Качество данных: есть ли ожидаемый объём и насколько свеж результат. Эти проверки обычно нужно строить отдельно.
Если смотреть только на статус последней задачи, очередь из ожидающих запусков останется незаметной. Если смотреть только на ресурсы сервера, можно не увидеть, что ежедневная витрина обновилась неполностью.
Путь метрики: от процесса до графика
1. Компонент Airflow создаёт сигнал
Во время работы Airflow фиксирует события и измерения: состояние задач, длительность операций, работу планировщика и другие показатели. Набор доступных метрик зависит от версии, конфигурации и включённых компонентов. Важно не привязывать систему наблюдения к одному названию метрики, не сверив его с документацией именно для используемой версии.
Метрика — не журнал событий. Она сжата до числового значения и набора меток. По ней удобно заметить рост ошибок или задержек, но обычно нельзя восстановить весь контекст запуска. Для этого нужны журналы и сведения о конкретном DAG и задаче.
2. StatsD переносит измерения
В Airflow можно включить отправку метрик в StatsD-совместимый приёмник. В распространённой схеме процесс Airflow отправляет измерения, а рядом работает statsd_exporter. Экспортёр принимает формат StatsD и предоставляет метрики в формате, который умеет забирать Prometheus.
Это промежуточное звено решает задачу совместимости, но добавляет свою точку отказа. Если приёмник недоступен, метаданные задач могут продолжать сохраняться в Airflow, тогда как часть телеметрии не попадёт в Prometheus. Особенно важно учитывать транспорт: в распространённой конфигурации StatsD использует UDP, который не подтверждает доставку каждого отдельного измерения.
3. Prometheus забирает данные
Prometheus обычно не ждёт, пока Airflow пришлёт ему каждую метрику. Он периодически опрашивает endpoint экспортёра — этот способ называется pull-моделью. Если опрос не состоялся, свежих точек измерения нет, хотя сама задача могла отработать нормально.
Дальше правила обработки вычисляют агрегаты и условия для алертов. Панель может показывать частоту ошибок, длительность задач или число запусков. Но пустой график сам по себе неоднозначен: проблема могла быть в Airflow, приёмнике, экспортёре, сетевом доступе или расписании опроса Prometheus.
Статус задачи отвечает на вопрос «что произошло с запуском». Свежесть данных отвечает на другой вопрос: «получил ли пользователь результат вовремя».
Где искать задержку и потерю сигнала
Полезно разложить время от планового запуска до готового результата на этапы: ожидание запуска, выполнение задачи, передача метрики, ожидание следующего опроса Prometheus и срабатывание правила алерта. Это не готовый замер, а схема измерения: конкретные значения нужно получить на своей инфраструктуре.
| Наблюдение | Что оно может означать | Что проверить |
|---|---|---|
| Задачи выполняются дольше обычного | Медленнее стали задача, источник или хранилище | Длительность по отдельным задачам, журналы запуска, нагрузку зависимых систем |
| Растёт ожидание перед запуском | Планировщик или исполнитель не успевает обработать очередь | Число ожидающих задач, состояние компонентов Airflow и доступность метабазы |
| В Airflow есть запуски, но на графике пробел | Метрики не дошли до экспортёра или Prometheus не опросил endpoint | Доступность StatsD-приёмника и экспортёра, ошибки опроса, временные метки точек |
| DAG завершился успешно, но данные устарели | Успех исполнения не равен полноте или свежести результата | Время последней записи, ожидаемый диапазон данных, проверки объёма и качества |
Для диагностики сопоставляйте один запуск по времени и идентификаторам: состояние в Airflow, журналы задачи и интервал метрики. График с агрегатом за несколько часов полезен для тренда, но может скрыть единственный пропущенный запуск.
Что чаще всего ломается в проде
Метрики есть, но алерт опаздывает
Задержка складывается из интервала опроса Prometheus, окна вычисления правила и времени доставки уведомления. Если запуск идёт по расписанию, которое само по себе нечастое, правило может сработать только после того, как проблема уже повлияла на потребителя. Настраивайте сигнал от требуемого срока готовности данных, а не только от факта ошибки задачи.
Метки раздувают временные ряды
Каждая уникальная комбинация меток создаёт отдельный временной ряд. Если в метки попадают идентификаторы запусков, динамические значения или другие высокоизменчивые поля, объём рядов может резко вырасти. Это увеличивает расход памяти и усложняет запросы.
Кардинальность — число уникальных комбинаций меток у метрики. Для мониторинга обычно нужны ограниченные измерения вроде имени DAG или типа состояния, а не уникальный идентификатор каждого запуска в каждом ряду. Полезную детализацию конкретного запуска лучше искать в Airflow и журналах.
Одна проверка пытается заменить все остальные
Алерт «задача упала» не ловит задачу, которая формально завершилась успешно, но записала неполный результат. А проверка количества строк не объясняет, почему запуск вообще не начался. Разделяйте сигналы: доступность оркестратора, выполнение по расписанию, свежесть результата и проверки качества данных.
Как проверить систему без выдуманных нормативов
Универсального числа, после которого любой конвейер считается медленным, нет: допустимая задержка зависит от расписания, объёма данных и срока, к которому результат нужен пользователю. Снимите базовый профиль на нескольких обычных циклах и зафиксируйте условия: версию Airflow, тип исполнителя, количество параллельных задач, объём данных и интервал сбора метрик.
- Проверьте полный маршрут. Убедитесь, что Airflow создаёт метрики, приёмник доступен, экспортёр отдаёт данные, а Prometheus успешно его опрашивает. Проверка пройдена, если новый запуск отражается и в состоянии Airflow, и на графике.
- Сравните время этапов. Отдельно измерьте ожидание запуска, выполнение задачи и задержку появления метрики. Проверка пройдена, если видно, какой именно этап добавил время.
- Добавьте сигнал свежести. Контролируйте время последнего ожидаемого результата или другой показатель, связанный с вашим расписанием. Проверка пройдена, если пропуск цикла обнаруживается даже при отсутствии явного статуса ошибки.
- Проверьте алерт на сбое. В тестовом окружении смоделируйте недоступность компонента или неуспешный запуск по безопасному сценарию. Проверка пройдена, если уведомление приходит в заданный командой срок и содержит ссылку на диагностику.
Не сравнивайте два замера, если между ними изменились параллельность, объём данных или интервал сбора: разницу нельзя будет приписать конкретной настройке. Сначала зафиксируйте условия, затем меняйте один фактор.
Где эта схема не сработает
Метрики Airflow описывают оркестрацию, а не всю систему обработки данных. Если задача запускает внешний сервис, сбой может произойти за границей Airflow. Если источник отдаёт запоздавшие записи, запуск завершится успешно, но содержимое будет неполным. Для таких случаев нужны проверки на уровне источника и целевого хранилища.
Есть и эксплуатационная граница: если метабаза перегружена, компоненты могут поздно обновлять состояния, а график будет показывать картину с задержкой. Поэтому при расследовании инцидента сверяйте телеметрию с журналами и фактическим результатом, а не считайте один дашборд источником истины.
Что делать дальше
Начните с одного критичного DAG: отметьте время планового старта, фактического запуска, завершения и появления результата у потребителя. Затем добавьте отдельные алерты на отсутствие запуска, рост задержки и нарушение свежести данных. После этого проверьте кардинальность меток и поведение всей цепочки при недоступности приёмника метрик. Так вы увидите не просто, что задача стала красной, а на каком участке конвейер перестал укладываться в срок.
Задачи: математика, физика, химия: Разбор задачи по шагам с проверкой и похожей задачей
Спросить за 10 ₽Источники: Apache Airflow 2.10 — Metrics, Prometheus StatsD Exporter — документация проекта
Частые вопросы
Если задача завершилась успешно, можно ли считать данные готовыми?
Почему метрик нет в Prometheus, хотя запуски видны в Airflow?
Нужно ли добавлять идентификатор каждого запуска в метки?
Подойдёт ли эта схема для другой версии Airflow?
Что делать, если задача зелёная, а данные опоздали?
Какие метрики важнее всего для продакшена?
Материал носит информационный характер и подготовлен редакцией «Агентуры». Он не является офертой, рекламой или индивидуальной консультацией. Упомянутые продукты, компании и торговые знаки принадлежат их правообладателям. Перед принятием решений, влекущих юридические или финансовые последствия, обратитесь к профильному специалисту.