Кэширование промптов: как срезать счёт за агентов вдвое
Prompt caching у OpenAI, Anthropic и Google по-разному режет цену повторяющегося контекста в агентных пайплайнах. Разбираем, где скидка автоматическая, где ручная и сколько реально экономят.
Prompt caching у OpenAI, Anthropic и Google по-разному режет цену повторяющегося контекста в агентных пайплайнах. Разбираем, где скидка автоматическая, где ручная и сколько реально экономят.
Агент на LLM звучит просто, пока не считаешь счета и секунды. Каждый вызов модели, каждый цикл рассуждения и каждый вызов инструмента — это деньги и задержка, которые складываются в цепочку.

За словом «агент» скрывается конкретный цикл из четырёх шагов: восприятие, планирование, действие и рефлексия. Разбираем, как он работает и где ломается.

Агент прошёл 70% задач в SWE-bench — и что это значит на практике? Разбираем, какие бенчмарки для агентов используют лабораторные команды, что они реально измеряют и где обманывают.

Автономный агент, который сам вызывает API и пишет в базу, ошибается дороже чат-бота. Разбираем, какими инструментами ограничивают его поведение — от NeMo Guardrails до Llama Guard — и где у каждого предел.

Агент вызвал API, а тот вернул 500. Что происходит дальше — зависит от того, как построена обработка ошибок. Разбираем стратегии, которые отличают рабочего агента от бесконечного цикла с сожжённым бюджетом токенов.

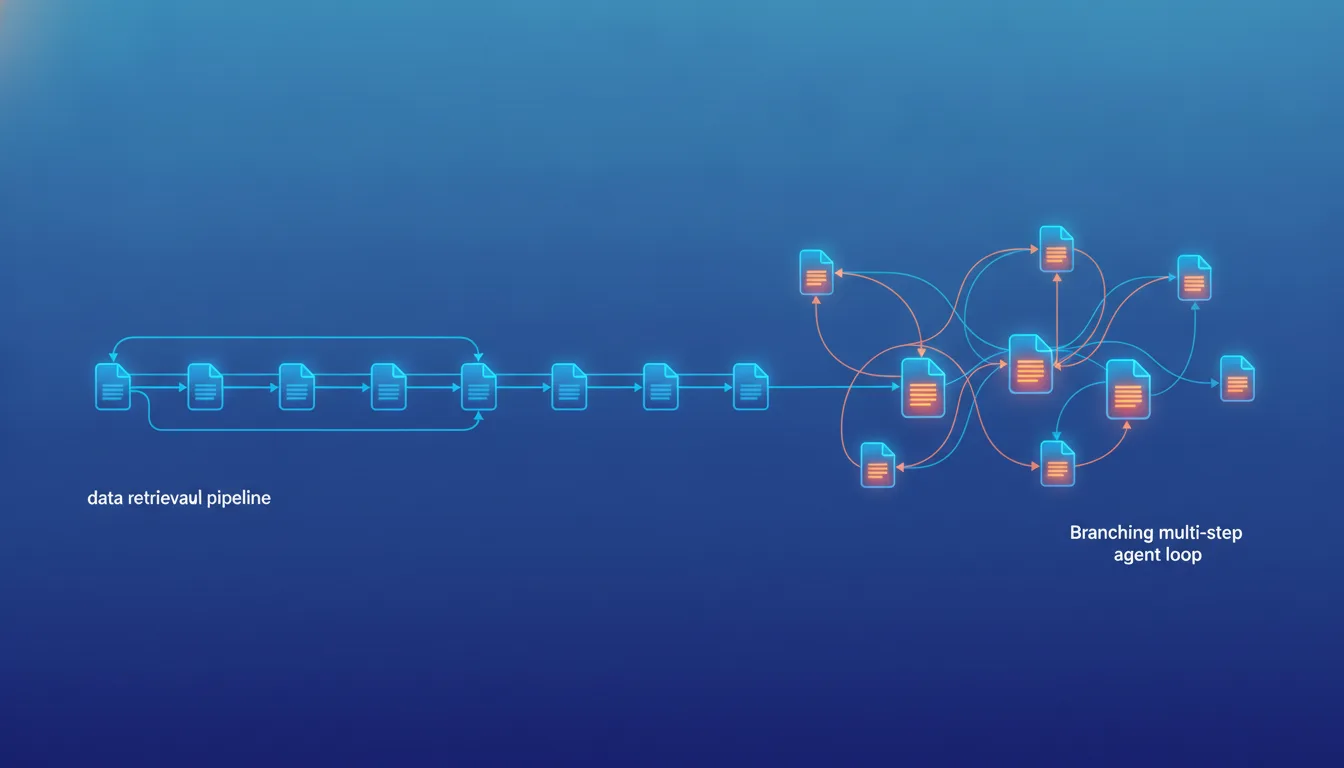
Классический RAG отвечает на вопрос по документам за один проход. Агент с доступом к той же базе умеет искать несколько раз, уточнять и проверять себя. Разбираем, где разница видна в деньгах и качестве ответов.

Разработчики агентов гонятся за длинным контекстным окном, но на практике модель теряет данные из середины запроса. Разбираем, где рвётся качество и что с этим делать.

Планирование стало главным узким местом ИИ-агентов: модель понимает запрос, но заваливается на многошаговых задачах. Разбираем, как работает декомпозиция целей и почему она пока ломается.

Модель сама не звонит в API и не открывает браузер. Она возвращает структурированный запрос, а вызов делает ваш код. Разбираем, как модель выбирает нужный инструмент и где эта схема ломается.

Векторная база — это память для LLM-агента: она хранит эмбеддинги и находит релевантные куски текста по смыслу. Разбираем, чем отличаются pgvector, Pinecone, Qdrant и Weaviate и когда без них можно обойтись.

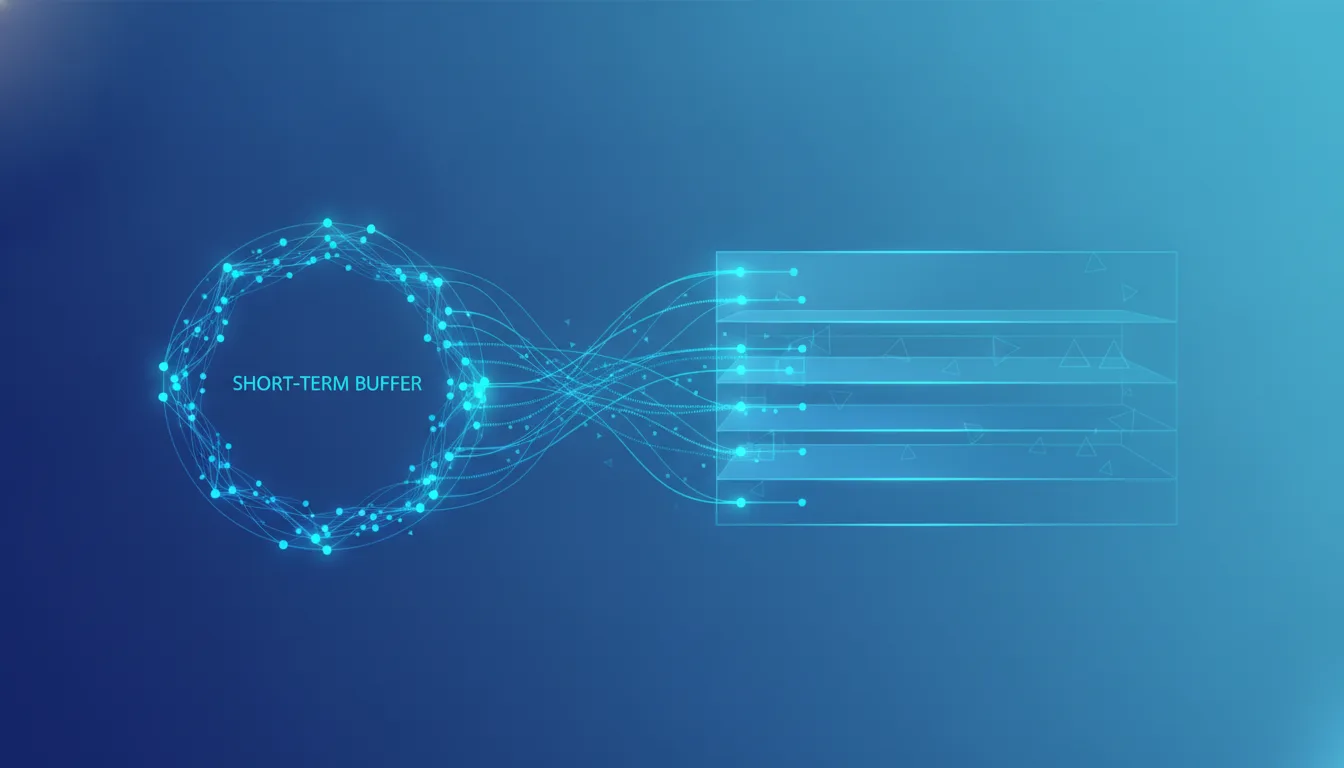
Агенты забывают всё, что не поместилось в контекстное окно. Разбираем, чем отличается краткосрочная память от долгосрочной, как её строят через RAG и векторные базы и сколько это стоит.