Символьный ИИ против нейросимвольных агентов: спор о будущем
Чистые нейросети галлюцинируют и не умеют объяснять свои выводы, чистая логика не масштабируется. Нейросимвольный подход обещает соединить оба мира — и уже пробует это в агентах.
Чистые нейросети галлюцинируют и не умеют объяснять свои выводы, чистая логика не масштабируется. Нейросимвольный подход обещает соединить оба мира — и уже пробует это в агентах.
Один агент читает только текст и стоит копейки за вызов, другой видит скриншоты и графики, но обходится в разы дороже. Разбираем, когда переплата за мультимодальность окупается, а когда это пустая трата токенов.

Generalist-агент с одним большим промптом проще запустить, но на десятках инструментов начинает путаться. Разбираем, когда выгоднее разбить систему на узких экспертов и во что это обходится.

Один AI-агент дергает API и укладывается в секунды, другой кликает по кнопкам в браузере и ломается на новой вёрстке. Разбираем, когда какой подход экономит деньги, а когда — единственный рабочий.

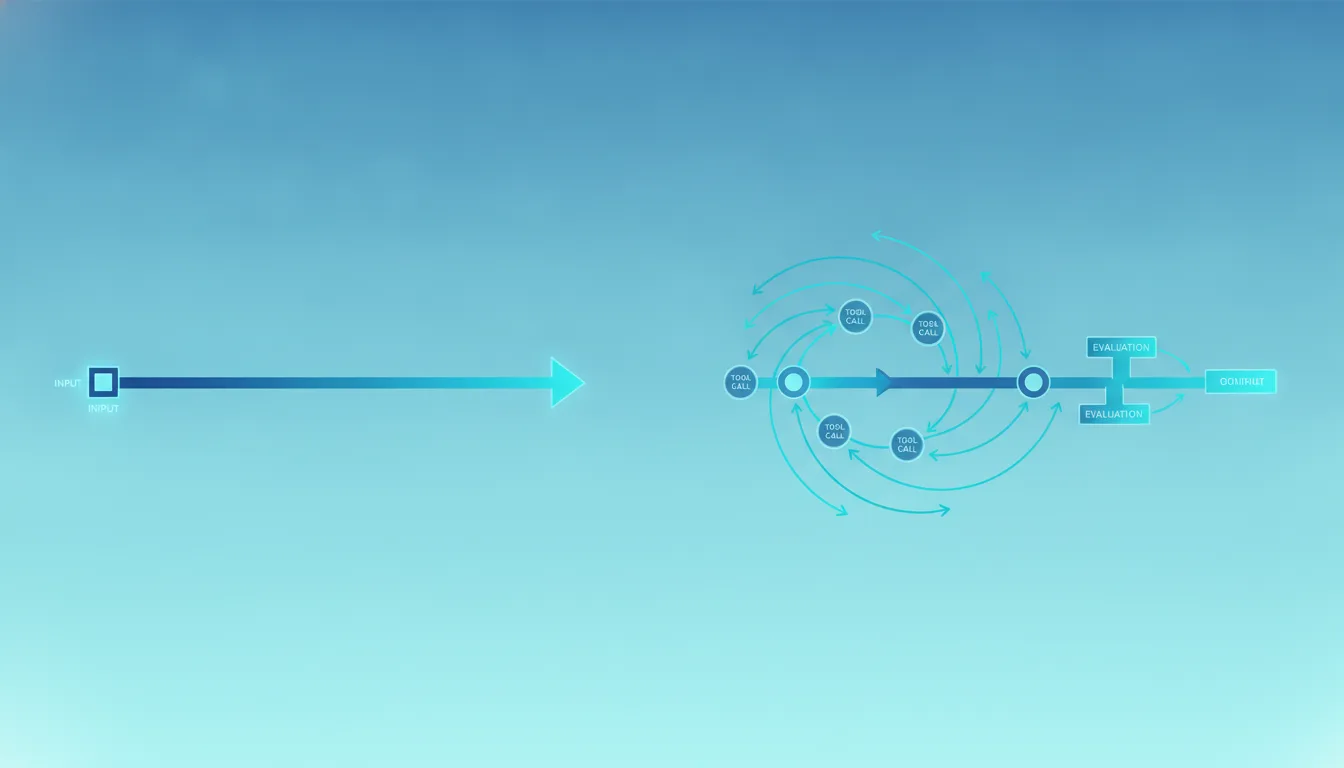
Автономный агент решает задачу за 40 вызовов модели там, где жёсткий пайплайн обошёлся бы одним. Разбираем, где эта плата оправдана, а где вы платите за отладку, которой не будет.

Два подхода наделяют агента знаниями: подключить внешнюю базу через RAG или дообучить модель. Разбираем, что дешевле, что точнее и когда одно не заменяет другое.

AI-агент, который сам жмёт кнопки, экономит время, но может удалить не тот файл. Агент-наблюдатель ничего не сломает, но и не сделает. Разбираем, где проходит граница и как её настроить под задачу.

Один запрос-ответ или диалог с состоянием — от этого выбора зависит цена вызовов, задержка и надёжность агента. Разбираем, где multi-turn оправдан, а где сжигает бюджет впустую.

Контекстное окно у топовых моделей выросло до сотен тысяч и миллионов токенов, но агенты всё равно забывают, о чём вы говорили вчера. Разбираем, чем долгосрочная память отличается от большого контекста и когда за неё стоит платить.

Старый сценарный бот отвечает по дереву заготовок и ломается на первом неожиданном вопросе. AI-агент рассуждает, вызывает инструменты и доводит задачу до конца. Разбираем, чем они отличаются на практике и сколько это стоит.

Один агент, который бронирует билеты, пишет код и разбирает почту, звучит заманчиво. Но на практике узкий агент под одну задачу чаще выигрывает по цене, скорости и предсказуемости. Разбираем, где проходит граница.

Один медленный вызов LLM в цикле может держать поток 20 секунд. Разбираем, когда агентный пайплайн стоит гонять синхронно, а когда переписать на async — с кодом на Python и ценой ошибки в задержке и деньгах.